周刊 · 第 145 期
把经验留下,把判断留给自己
一个 Agent 昨天已经弄清楚项目怎么启动、哪些测试有效,今天换个会话,又从头检查环境,重新提出那个被否决过的方案。设想一下这个场景:每一步看着都很认真,最后也交出了结果,可同样的钱和时间,下次还得再花。
相比「一个晚上能生成多少代码」,我更想知道:忙完这一轮,下一轮能少走多少弯路?
这期选了几篇和这个问题有关的文章:Anthropic 研究 Agent 怎么整理记忆,Tw93 谈 AI Coding 的验收和复盘,TokenEconomizer 尝试减少重复操作的成本。胡泳那篇讨论深度思考的文章,我也留了下来。读得快、存得多,究竟有多少会变成以后用得上的东西?这个问题也值得问自己。
📚 深度阅读
读完摘要以后
胡泳 11 月 1 日的 《刷短视频是否影响深度思考》刊于作者公众号,注明来源为《学习时报》。他关注的是一种使用习惯:内容和反馈切换得很快,人还愿不愿意在一个暂时没有回报的问题上停留?文章也说明,现有研究不足以证明长期刷短视频必然使人失去深度思考能力。
我更愿意顺着这个问题想想 AI 阅读。让它先概括一篇文章很方便,尤其在判断值不值得读的时候。麻烦在于,摘要往往已经把话说圆了,让人觉得没有什么可追问的。
比如读到一个「AI 显著提高效率」的结论,我想知道它测的是什么任务,有没有算检查和返工的时间。缺了这些,结论很好记,轮到自己作决定时却用不上。信息源即使换成论文,也不能省掉这一步。
读完后能说清作者的理由,再留一个自己还没想明白的问题,我觉得就不错。不必每篇都整理成笔记,更不必为了凑出几条收获,让 AI 替自己宣布「学到了」。
Agent 记错了,谁来改
11 月 6 日,Anthropic 发布了 The components of agent memory。它把会话中记录重要信息,与事后回看记录、整理记忆分开讨论,后者称为 dreaming。这里处理的是后续会话能读取的外部记忆,不涉及重新训练模型权重。
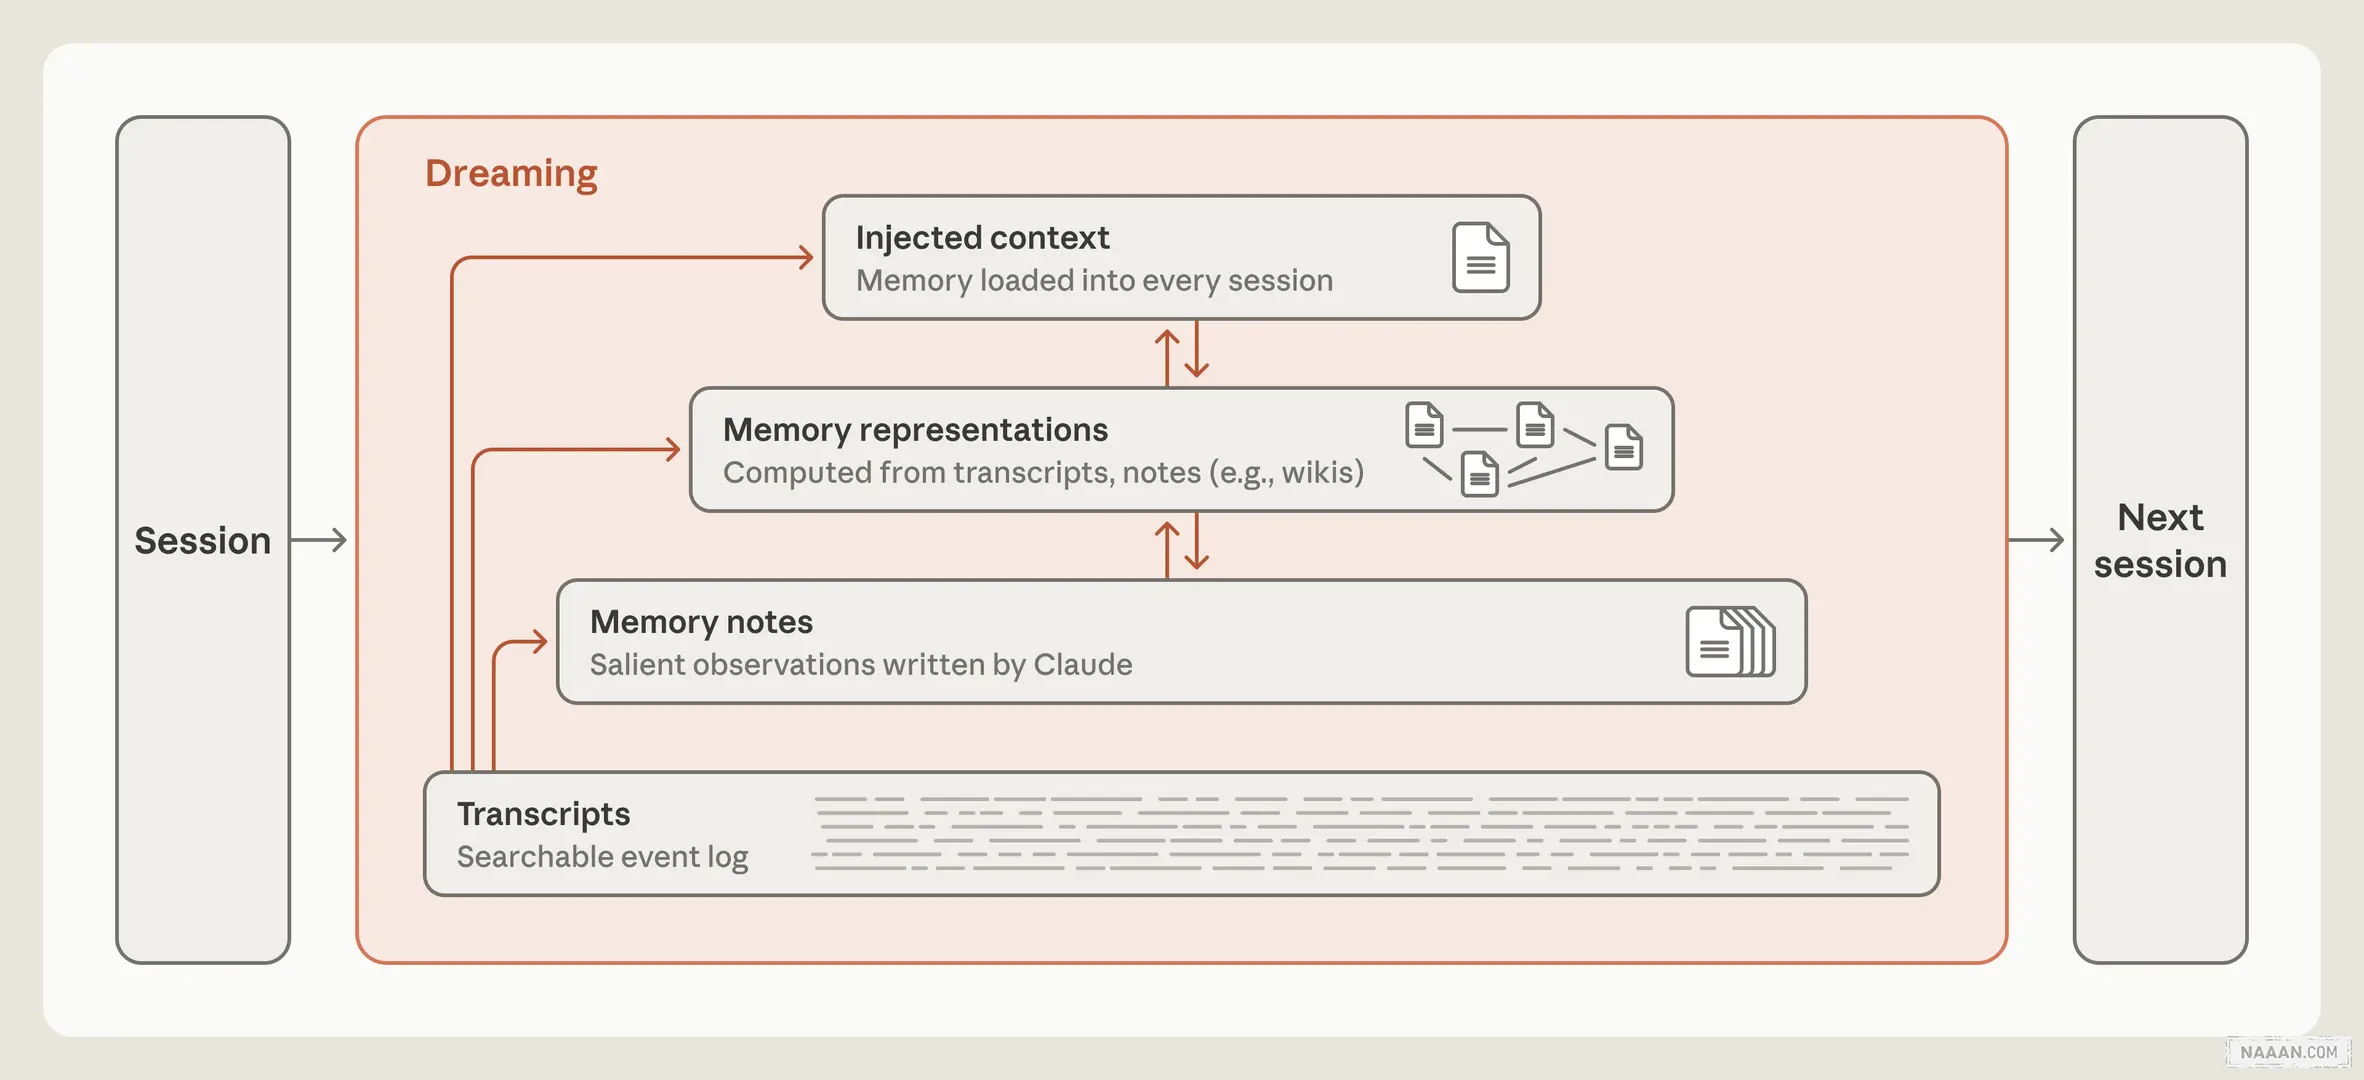
图:Anthropic 的 Agent 记忆层级与 dreaming,来源:原始研究文章。
文中一个游戏案例值得留意:Agent 把地标位置记错了,后面依赖那条笔记,反复走错路。回看原始会话、纠正笔记之后,行动才改变。研究也出现了 wiki 帮助有限、体量甚至超过原始材料的情况。多整理一层,并不总能帮上忙。
我对那个错误地标更在意。没有记忆时,Agent 至少还会去找;有一条错误记忆,它反而有理由相信自己已经知道了。个人笔记也有类似的麻烦:一条结论存进正式目录,过几个月再翻出来,很容易忘记它当初只是猜测。
所以我愿意给准备反复使用的经验多留一点出处。「这个命令能跑测试」,附上验证时的环境和版本;「用户不需要这个功能」,留下对应反馈。以后碰到矛盾,还能回头查,而不用猜当时为什么写了这么一句。
至于整理笔记,我不太想再用文件数量衡量它。删掉一条过期规则,或者给一个含糊结论补上出处,可能就够了。
21 条实践里,我想留下验收办法
Tw93 的 《2026 年,我的 21 条 AI Coding 最佳实践》发表于 10 月 29 日,这周拿来作背景阅读。文章从需求写到规则、审查和复盘,包括拆小改动、用可执行的检查约束行为,以及把线上问题变成后续验证案例。
其中我最认同的是:交代工作的时候,就把怎样算做好也说清楚。这句话听着普通,真写需求时却很容易漏。
假设要给一个二十人的活动做报名页。只说「做个报名页」,Agent 很快就能交出界面。但名额满了怎么办?同一个人报两次怎么算?取消后要不要释放名额?组织者怎么导出名单?这些才决定它能不能用。
按钮颜色、数据库选型、目录结构可以写得很详细,依然绕过了这些问题。我宁愿先把报名和取消的几种情况列出来,让 Agent 用它们检查结果。
这样的验收办法下次还能继续用。换了模型,或者换个人接手,也不用重新猜「当时说做好,到底是什么意思」。
🤖 AI 工具
TokenEconomizer:少付几次重复学习的钱
TokenEconomizer 由微软研究院、加州大学伯克利分校等机构的研究者提出。10 月 15 日提交的论文报告,在测试的 Agent 与模型组合中,平均 token 成本降低约 18.4%–30.9%,任务成功表现相当。这个范围对应论文实验,不能直接套到自己的订阅账单上。
它从仓库的连续会话中积累操作经验,减少长期不用的工具定义,并在重复失败时提供转向提示。项目 README介绍了这三种机制;其中 micro-skills 默认关闭,需要单独开启。
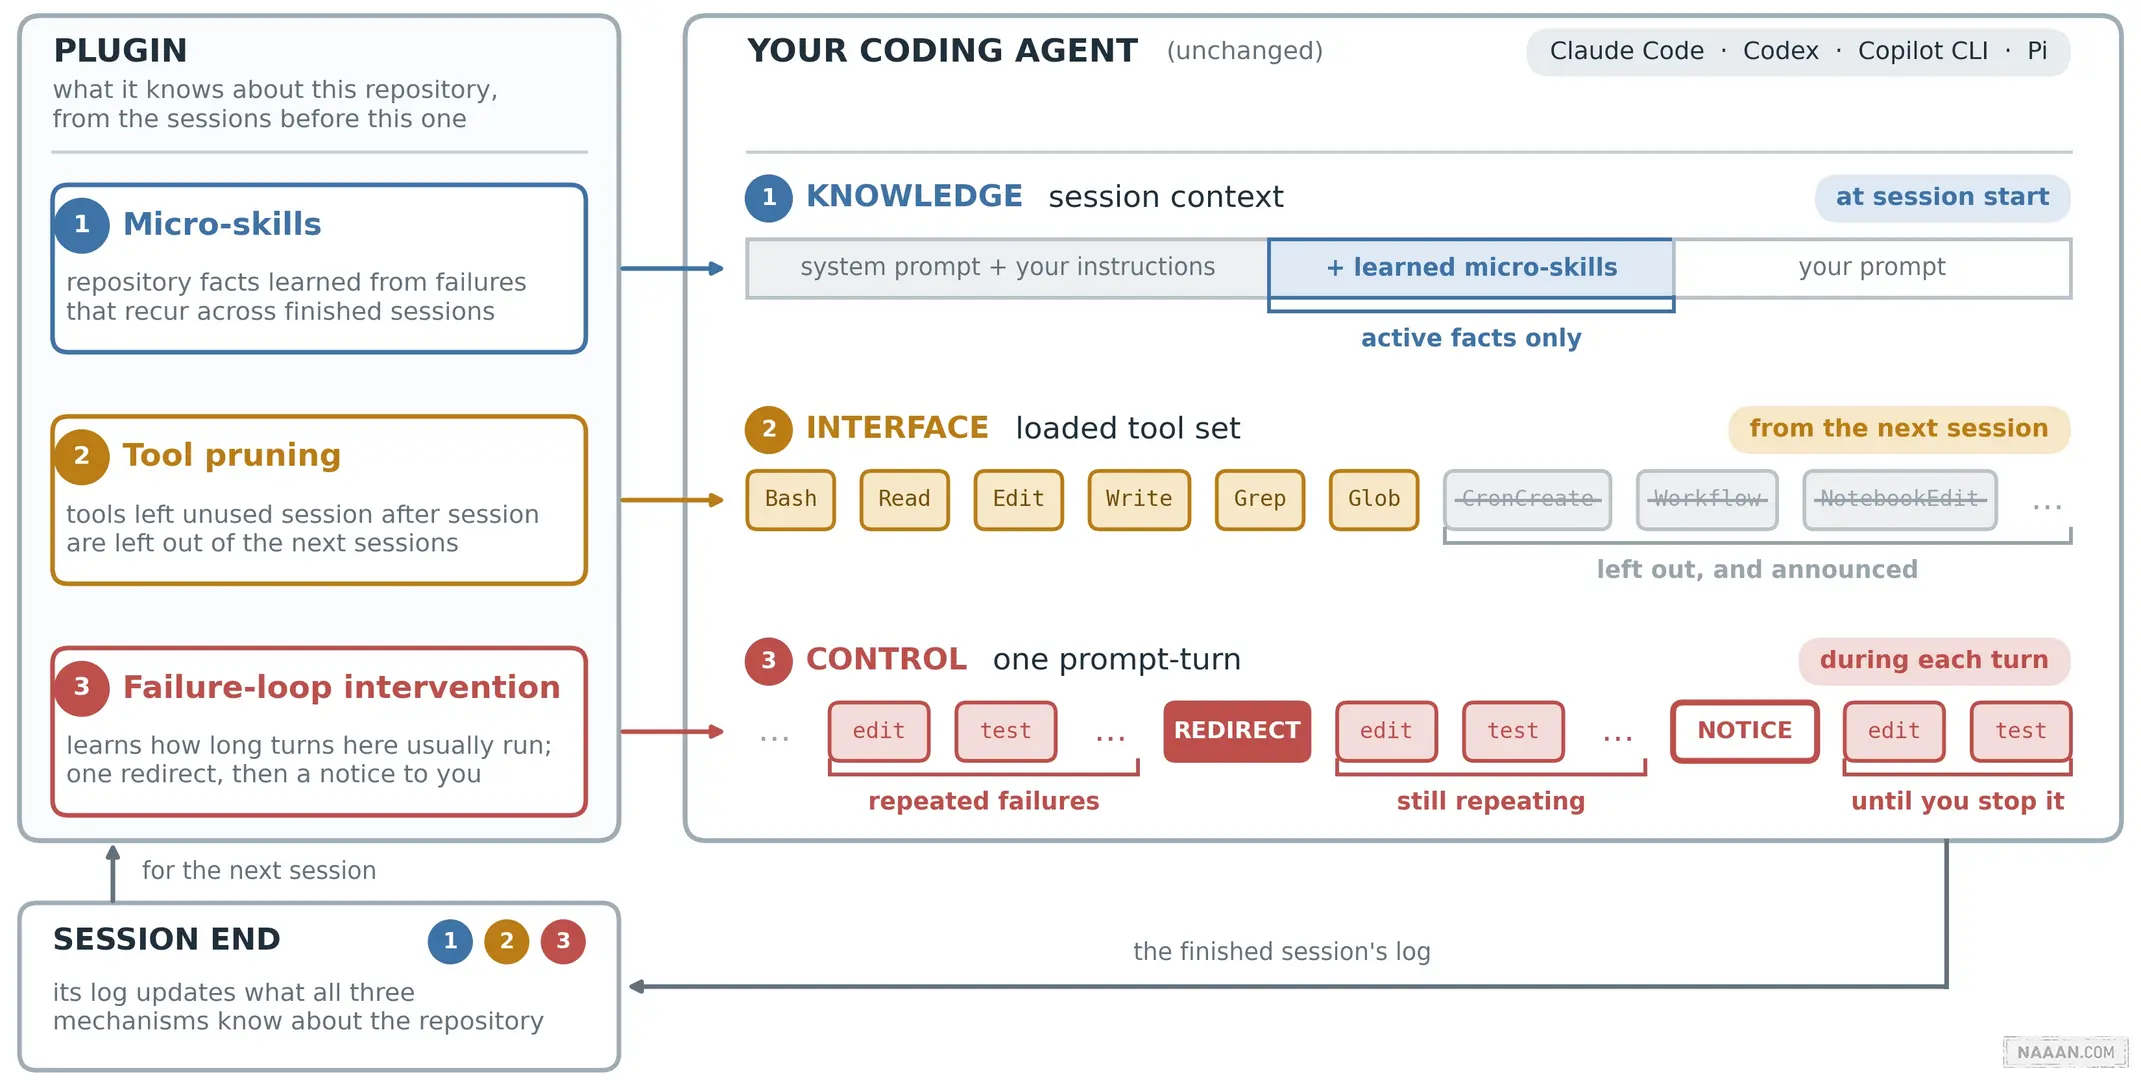
图:TokenEconomizer 项目原始机制图,来源:Microsoft / TokenEconomizer。
我喜欢它把省钱的问题拆到了具体操作上。同一种错误试了五次,后四次有没有得到新信息?一长串工具定义每次都带着,其中多少真正用到了?这些比单独比较模型价格更容易看出浪费在哪里。
当然,删工具和存经验都有可能帮倒忙:刚删掉的工具下个任务要用,昨天验证过的命令今天换环境就失效。我会把任务完成情况和费用放在一起看,也想知道这些调整能不能撤回。光看到 token 曲线降了,还不足以决定要不要留着它。
Agent-Autoloop:需要我决定时,把事情说清楚
卡兹克在 11 月 4 日的开源说明中介绍了 Agent-Autoloop。它把事件发现、规则派工、Agent 执行和通知拆开。需要人决定时,执行进程可以退出,保存等待状态,收到答复后再续接。
README 还介绍了事件记录、外部资料与本地指令分离,以及任务链路的跳数限制。部分集成和场景模板目前只经过本地验证,实际接入前要对照仓库里的验证范围。
这个项目让我感兴趣的是它怎么等人。后台自动化做到一半,问一句「是否继续」,其实没有完成交接。我得先弄清它做到了哪一步,才知道那个按钮该不该按。
我希望收到的消息能直接说明:已经完成什么,卡在哪里,需要我选什么,以及选完会发生什么。如果还得打开终端翻一遍记录,通知再及时,也只是把排查工作交给了我。
另一件要确认的事是暂停之后怎么接着做。哪些动作已经执行,重试会不会重复发消息或重复提交?我会先拿一个低风险的小任务试这段流程,尤其看看它能否在答复后接对位置。能跑起来只是开始,来回交接顺不顺,才影响我是否愿意长期用它。
✨ 随便看看
Cursor 可上线应用:11 月 5 日的更新把数据库、身份验证和托管放进构建流程;检查通过且用户明确发布后才上线。做完就能发给别人用,很方便;上线后的访问权限和维护仍需安排。官方更新
Amp Spaces:11 月 6 日发布,由一个 Agent 协调其他工作线程,团队在同一空间讨论和查看汇总。我想看它能否减少人来回转述进展的时间,具体效果还要放进团队工作里观察。官方说明
这期写到最后,我想先留下一个很小的做法:一项工作结束时,问问有什么是下次不用重新查的,把它和验证依据放在一起。可能只是一条命令,也可能是一个已经否决的方案及其原因。
先不急着搭完整的记忆系统。等下次真的用到,再看看这条记录有没有帮上忙。用不上就改,过期了就删。这样留下来的经验,才值得继续带着。