L142_器在贬值,事在升值
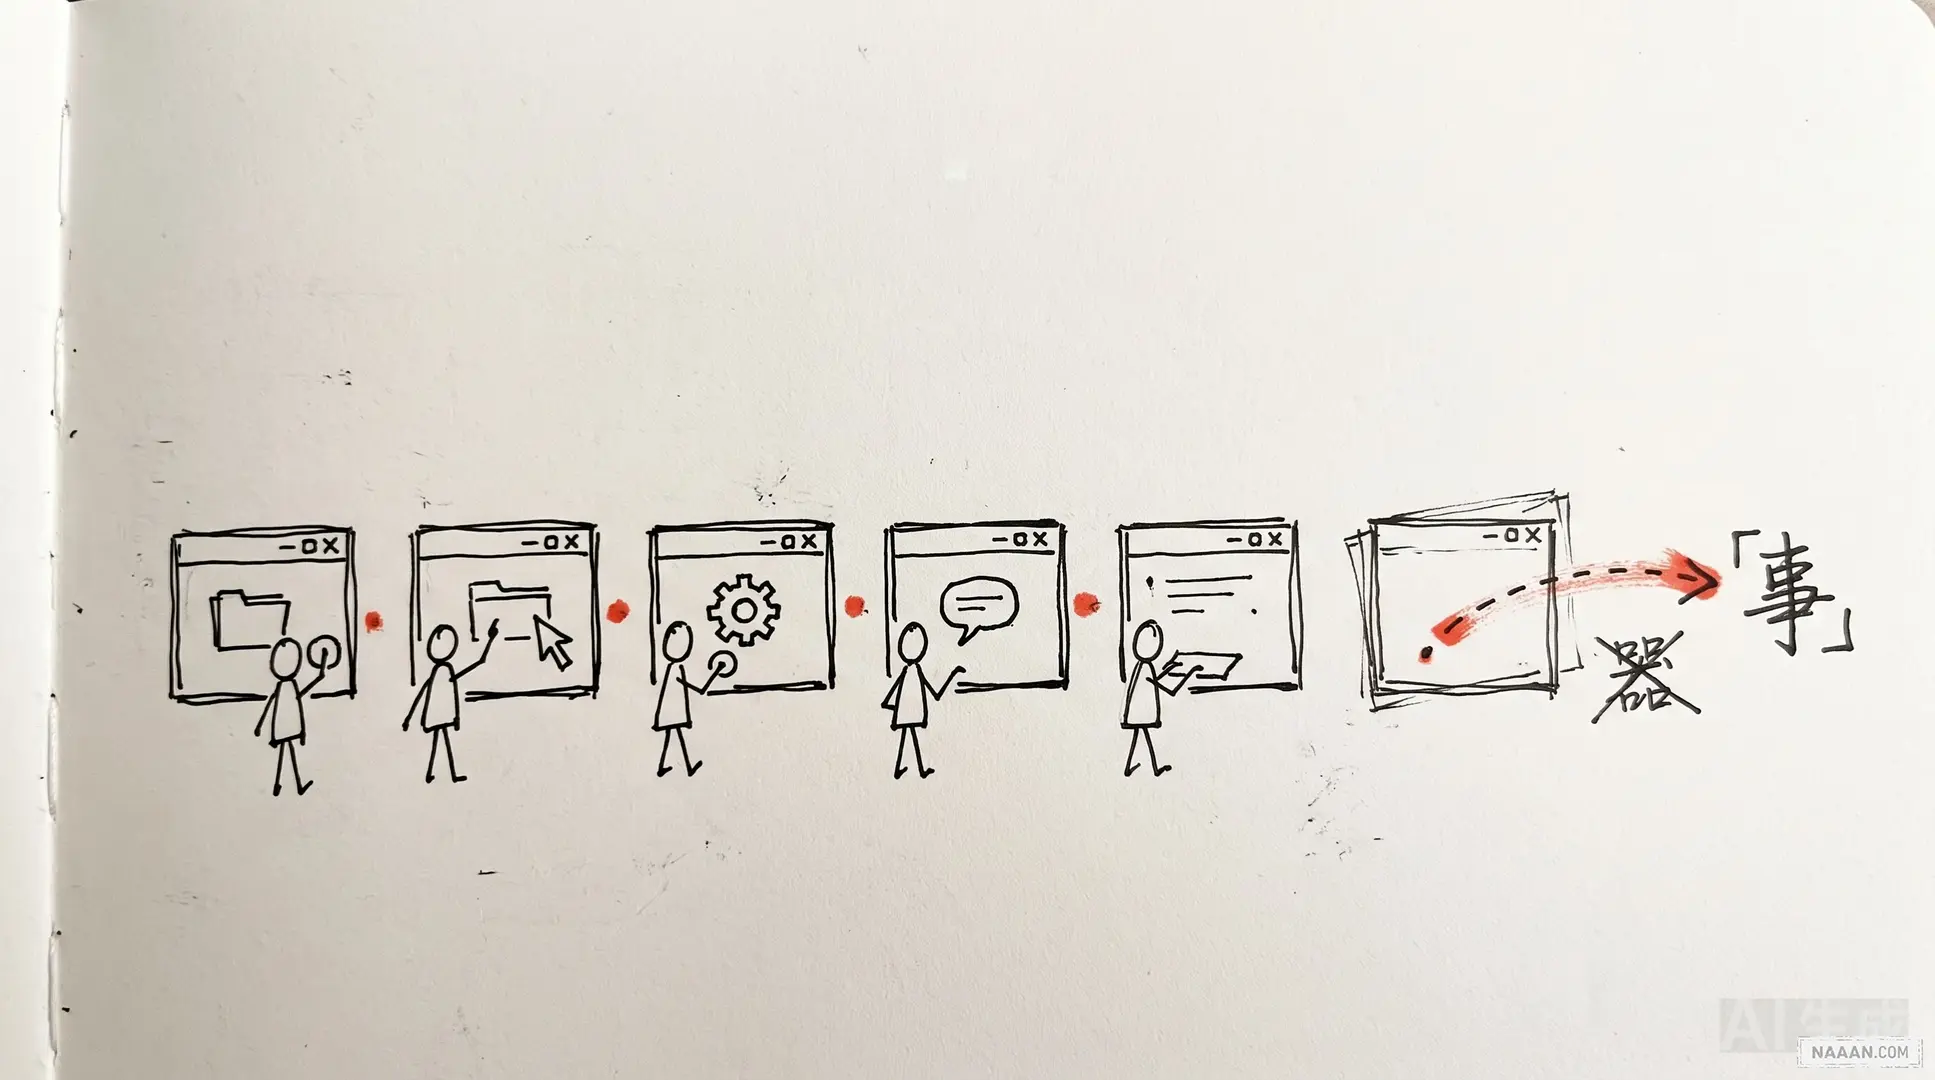
这周一个做了十年设计的朋友来找我,说想把「Agent 那套」学起来,问我先装哪个。
我张口想报几个名字,报到一半卡住了。因为我想起来,那几个东西我已经很久没打开过界面了——我只是把事丢给它,然后去看结果。他又问了个更具体的问题:某个功能在哪一栏。我答不上来,顺口说了句「我让 Agent 点」。
他愣了两秒,笑着问:「那你到底还会不会用?」
这句话把我钉在那儿了。
说来好笑,我在这行待了快十年,简历上曾经写过「精通」七八个软件的名字,那些词一度是我谋生的凭据。可现在,面对一个最朴素的「你会不会用」,我居然答不上来。不是不会,是那个问题本身已经不对我的生活生效了。
—
我花了几天想这件事,越想越觉得这不是我一个人的小尴尬。
过去二十年,存在一种可以明码标价的中介能力,叫「会用工具」。招聘 JD 上写「熟练使用 Excel」,简历上写「精通 Figma」,公司里最值钱的是「那个懂系统的人」。这种能力的结构很特殊:你不直接生产结果,你操作一个东西去生产结果。它之所以值钱,是因为器有门槛——门槛就是租金。
这一周读到的几份材料,几乎是在从不同方向拆这道门槛。
一位做投资的朋友在演讲里说得很直接:写代码、做图、翻译、生成 PPT,这些单点能力的供给越来越多、壁垒越来越低、切换成本趋近于零,所以它们的利润必然趋近于零。他把这件事浓缩成六个字——利不在器。
顺着这个判断往下推,就会碰到一个让人不太舒服的问题:如果「会用器」不再值钱,那靠「会用器」建立起来的职业身份,地基在哪儿?
—
先把话说明白,免得被误读。这不是「人要被取代了」的老调。恰恰相反,这一周我读到的所有东西,指向的是同一个方向——人被从「器」里推了出来,推到了「事」的那一侧。
器是什么?是软件、是设备、是模型、是某个单点技能。事是什么?是要解决的麻烦、要交付的结果、要承担的后果。
过去,器横在人和事之间,你必须穿过器才能碰到事,所以器收过路费。现在这道关卡正在被拆掉:Agent 不需要「会」那个软件,它只需要看得见屏幕、点得到按钮;组织不需要「有个懂系统的人」,它只需要一个能被查询的数据库;连记录这件事,都不再需要一个「会写文档」的人,只要有人愿意把话说完。
器一旦不需要被操作,它就从「技能」退化成「耗材」——你能买到,别人也能买到,价格就会被压到接近成本。
所以这期的标题,我用的是那句「利不在器」。不是因为它好听,而是因为它把这一周所有看似不相干的事,收在了一句话底下:器在贬值,事在升值,而这两件事之间那个曾经站着人的位置,正在空出来。
至于空出来的地方该站谁、站上去之后要干什么——这是这一期真正想聊的。
📚 深度阅读
利不在器:为什么所有 20 美元的 AI 订阅终将被踏平
这篇是周喆吾写的,起点是一场中科大校友会的活动。一个新生站起来问:AI 来了,我该选什么专业才不被淘汰?旁边一位做了二十年投资的老校友接过话筒说:你问反了——你能考上这里,说明你是聪明人,问题不是选什么专业能躲开 AI,而是怎么站到 AI 这边来,去革别人的命。
我喜欢这个开场,因为它把「逃」和「进」这两件事分得很清楚。而整篇文章干的,就是解释「进」到底进哪儿。
他的第一刀,切在「为什么 AI infra 赚钱、AI apps 不赚钱」这个反差上。
常见解释是「卖铲子永远比挖矿赚」,他觉得这个解释太单薄。再往下问一步:谁在买铲子?不是 AI 创业公司,是传统企业买 AI infra 回去改造自己的供应链和服务。于是他给出了一句很锋利的对照——AI app for AI users 是零和博弈,传统行业买 AI infra 是增量创造。前者是在一群本来就赚不到钱的人之间抢钱,后者是让一个本来就在赚钱的生意多赚一点。
第二刀,切在「单点能力」上。
器盈则贱。写代码、做图、翻译、生成 PPT,供给多、壁垒低、切换成本为零,利润必然趋零。他把这种现象叫作「踏平」——不是被谁打败,是被磨平。他举的例子很具体:Manus 刚起来就被 Muse Spark 截胡,Cursor 势头正猛转眼 Claude Code 出来了。都不是产品做得不好,是这个位置本身不承重。
那什么承重?他的答案是 workflow capture:接管一条完整的业务流程,交付一波明确的营收增长。他给了一个特别实在的算法——帮客户一个月多赚 50 万,可以收他 30 万,他不在意你背后跑什么模型。所以在他这套逻辑里,token 成本根本不是 AI 落地的核心瓶颈,决定性因素只有一个:能不能跑通全流程的增量营收。
客户愿意长期付费的 KPI 也只有一类:绑定在真实 P&L 上的垂直 ROI。其余皆为 demo。
后面那句算账公式,我抄下来了:替人率 × 人数,乘出来就是可分割价值。顺着这个逻辑,他点名了目前最好的靶场——电商、直播、游戏公会、保险销售团队、网课销售团队。共同特征是:大量白领做重复度高的认知劳动,人力是最大成本项,产出直接可量化。
第三刀最狠,也最容易被忽略:这不是需求侧的生意,是供给侧的生意。
他先否掉了需求侧。帮你比价、筛选、做决策,有用,但用户不愿付费——你用 AI 帮你挑了一条裙子省了十分钟,你不会为此每月付二十块。然后他把镜头切到供给侧:企业用 AI 重做产品、服务和运营,AI 的成本进 COGS,靠更好的 unit economics 覆盖。消费者根本不知道后面有 AI,只知道这家东西更好、价格更合理、服务更到位。
这里有一段判断,我觉得是全文最有价值的:
过去品牌卖完一件商品,和消费者的关系基本就断了。不是不想维护,是维护成本太高。持续理解每个客户的偏好、主动提供个性化售后,传统成本结构下只有奢侈品牌对顶级 VIP 做得起。当认知劳动成本趋零,你可以从第一天就把这种能力写进产品定义和组织架构里。
也就是说,真正发生的不是「客服效率提高 30%」,那是优化;而是**「什么样的企业,在经济上第一次变得可行了」**,那是变革。
我的看法,有三层。
第一层是认同:这篇把「AI 应用不赚钱」这个模糊的体感,拆成了一个可以检查的结构——你是零和博弈还是增量创造?你接管的是单点还是流程?你的客户 KPI 绑在 P&L 上还是绑在「感觉不错」上?这三问拿去体检任何一个 AI 产品,都能问出东西来。
第二层是提醒。那个公式「替人率 × 人数」非常诚实,诚实到有点刺眼:它的本质是向下议价——把一群人的劳动价格压到零,然后从省下的钱里分成。这在商业上完全成立,在政治上一定会有反弹。而「供给侧」这个词很巧妙,它把这件事包装成「给消费者更好的产品」,从而绕开了那个真正的问题:这批被替掉的人,去哪了?文章没有回答,我也不打算在这里替它回答,但我觉得读这篇的时候,心里得给这个问题留个位置。
第三层是不同看法。他赌的是「token 成本明年降 30 倍,敢在这个窗口期亏着干的人,吃到的是成本曲线的时间差红利」。我的疑虑是:成本下降的同时,任务的复杂度也在上升。单次推理确实越来越便宜,但 Agent 干一件事要花几十上百次推理,还要反复重试、校验、回溯。总账单是不是降的,取决于你让它干多复杂的事——这里有个杰文斯悖论的影子。他其实也承认了「今天的账面没打平」,只是把这当成战略投入。这个赌法没问题,但它不是「成本必然下降」的确定性,而是「成本下降的速度要快过我胃口膨胀的速度」的赌局。
最后那一段回到「利不在器,在器所成之事」,落到了鸿蒙智行:不卖 SaaS,不收咨询费,深入到产品定义和品牌运营里,和有制造能力的产业伙伴联合造面向消费者的产品,对经营结果负责,共享利润。
这条路很重,也很慢。但它确实回答了一个问题:如果器不值钱了,那值钱的到底是「事」,还是「能把事办成的那种组织能力」?
原文:周喆吾《利不在器:论为何 AI 应用都不赚钱》
🔗:mp.weixin.qq.com/s?__biz=MzU2MTgzMjQyMA==&mid=2247485185&idx=1&sn=d6baf9dc75704fd21b72c1a07f344d30
YC 把整个公司塞进了一个 Postgres
如果把「利不在器」当成诊断,那 YC 这份东西就是一份具体的施工图。
来源是 YC 普通合伙人 Pete Koomen 的一期播客(他此前创办了 Optimizely),中文整理版做得很细。整件事的起点特别朴素:要和财务团队一起做一批工具,用来登记日记账分录、记录融资定价这些活。传统做法是财务讲一遍复杂的流程,工程师翻译成软件,再交回财务用。这个过程非常低效。
同一时间,Pete 自己正在用第一代 Cursor 和刚出现的 Claude Code,感觉像获得了超能力。于是一个念头冒出来:为什么不在 YC 内部构建一些工具,让 Agent 跑起来,把财务从「依赖工程师」的循环里解放出来?
注意他的目标不是让财务学写代码,而是让财务用英文提示词编码自己的工作流。这个差别很小,但非常关键:前者是把人改造成程序员,后者是把人从等工程师的那个队列里解放出来。
第一个真正带来魔法感的,是一个共享的工具注册表。 其中一个关键工具让 Agent 能对 YC 数据库跑只读 SQL 查询,另一个让它能读模型文件。
一开始工具都很受限、领域很窄。但很快所有人都觉得挫败——限制太多,干不了真正想干的事。于是有人试着给 Agent 更完整的数据库访问权限。听起来像在违反规则,结果运行得非常好。
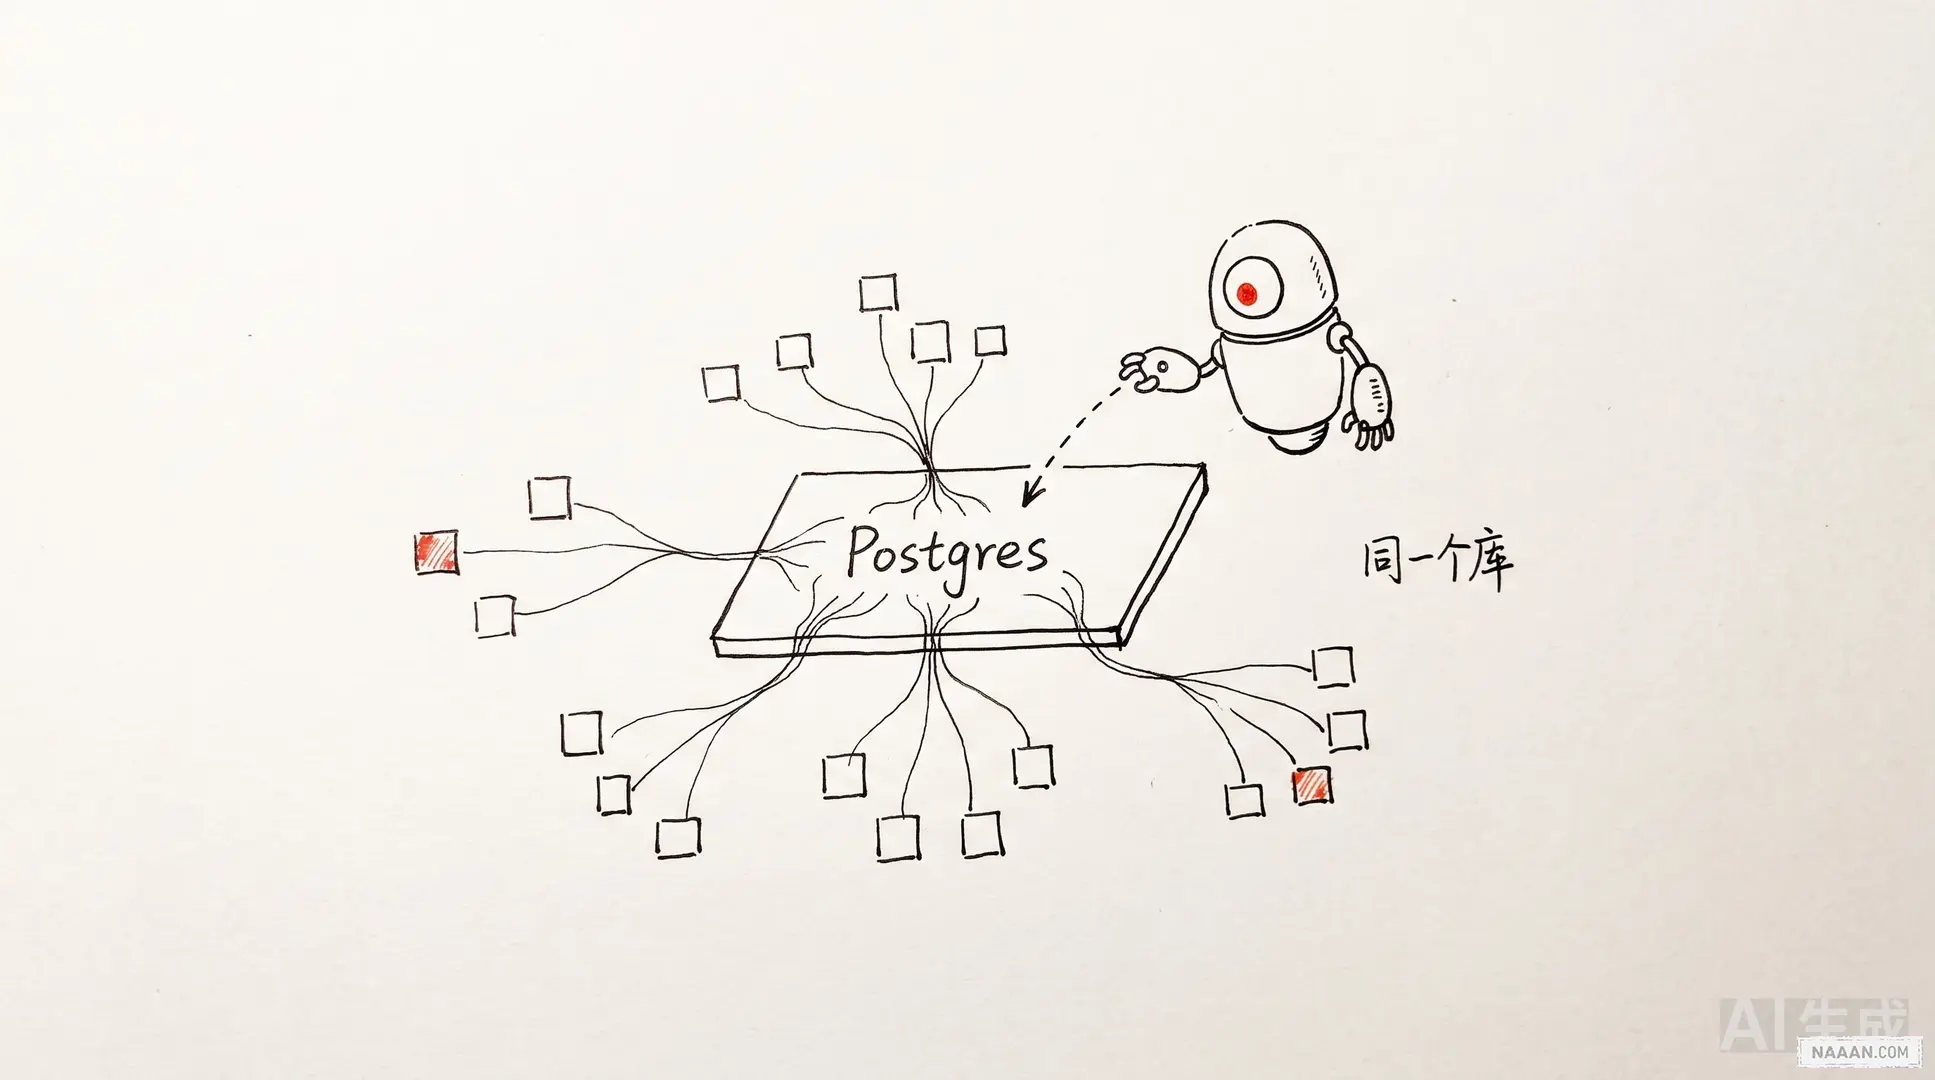
为什么 YC 敢这么干?因为它的基础设施有个别人没有的特征:YC 运行在自研软件上,而这些软件背后是同一个 Postgres 数据库。投过的公司、创始人、财务交易、内部 CRM 的笔记,全在里面。很多公司把这些职能分散在第三方 SaaS 里,YC 自己造了这些系统。所以它拥有一个包含所有重要上下文的单一数据库,再给 Agent 一点 schema 说明,它就能回答任意复杂的问题——比如「请列出过去四个批次里投资过太空相关公司的所有投资人」。
这里有一个我觉得整篇最重要的观察,整理者用了一个词:杰文斯悖论。
能力变强本身不稀奇,稀奇的是它带来的连锁反应——人们愿意提出的问题数量爆炸了。过去要用商业智能工具问一个「哪些投资人投过太空公司」,得写几个小时 SQL,除非这个问题极其重要,否则根本不会有人问。现在随口就问。当完成一件事的沟通成本下降,需求量就会显著上升。
这跟 140 期聊的推理成本塌陷是同一个机制,只是换了个场景:便宜不只是让同样的东西变便宜,它让原本「不值得问」的问题变成了「值得问」。 而这些问题里,藏着组织真正知道自己不知道的东西。
第二个机制,叫组织自我改进,也就是「梦境循环」。
发展路径很有意思:最早人们写自己的系统提示词,后来写技能(skill),再后来开始写元提示,让模型自己改进提示词和技能。现在 YC 已经有一些自治的自我改进循环。举的例子特别具体:一个通用智能体每天晚上读员工当天与它的对话,寻找它本可以做得更好的地方,以及「如果提前知道某些上下文,是否可以更高效地完成任务」。它还会读会议记录,把关于人和公司的信息写回内部数据库或 CRM。
落地的案例是「两句话描述」这个技能——用任何人都能理解的自然语言,说明公司做什么、以及为什么有趣。听起来容易,创始人写起来很难,因为创始人自己拥有完美上下文。合伙人 Tom 写了初始技能,小组 office hours 的会议记录又被智能体学进去,技能明显变好。Pete 认为它已经超过自己。
第三个机制,是默认开放。
YC 默认让全职员工都能看到智能体对话,并把它广播到内部 Slack 频道,任何人都可以加入查看和学习。这个决定并不容易,内部也讨论过「如果每个人都能看到一切,这是否可以接受」。最终他们选择保持开放,而且事实证明是对的——人们通过观察别人怎么用,学会了怎么用。
这段我觉得是全篇最值得抄的一句,因为它承认了一件事:「默认公开广播」既是学习机制,也是社会控制机制。 Agent 在获得大量上下文非受限访问时最强大,但这与大多数组织的运行方式相反;把对话默认公开,会形成一种社会控制,限制人们滥用能力。
然后他给出了那句被引用最多的话:真正智能体化、千倍效率的组织,必须具备两个特征——相对平等,以及默认信任。这两点在世界上大多数组织里都不存在。
我的看法。
第一,这套东西最容易被误读成「买个大模型 + 接个 MCP 就完事了」。但整篇真正的门槛不在技术,在**「同一个 Postgres」**。绝大多数公司的上下文不是不存在,是碎在十几个 SaaS 里,谁也没有权限把它们反规范化成一张为 Agent 优化的大表。这件事听起来像数据工程,其实是政治工程——它要求每个部门把自己的数据交出来,而且交到一个所有人都能查的地方。
第二,「梦境循环」这个词很漂亮,但它的实质是把「组织的记忆」从人的脑子里搬到一个 schema 里。好处是新人第一天就能调用老员工的直觉;代价是组织开始依赖一个它无法审计的东西。Agent 用只读 SQL 回答「哪些投资人投过太空公司」,没人能说清它中间走了哪几步、有没有漏掉一个改了名的表。
而 YC 对这个问题的解法非常「人」:不是做更严的审计,而是让所有人看得见。用社会透明度去替代技术可解释性。我认为这是这篇最有意思的地方——它承认了在 Agent 时代,信任不是算出来的,是长出来的,靠的是一群人长期在一个能互相看见的环境里工作。
第三,也是我的一点保留。「默认广播所有 Agent 对话」在 YC 行得通,是因为它小、同质、精英密度高、且所有人都清楚自己是来干什么的。搬到一家两千人的公司,同样的动作会立刻变成监控工具——这不是政策设计的问题,是组织性质的问题。整理者自己也加了一句很清醒的注:搬进两百人的公司,先得看看自己有没有那个信任基础。
还有那个数字,我觉得应该单独拎出来说:愿意每年花一万到十万美元买 token。这不是一个技术预算,这是一个组织决心的标价。它等于在说:我承认「让每个人都能随时问出复杂问题」这件事值这个钱。绝大多数公司的 AI 预算表上,没有这一行。
原文:Pete Koomen 在 YC 的分享《Inside YC’s AI Playbook》(中文整理:奶牛Denny《硅谷AI原生组织手册》)
🔗:youtube.com/watch?v=B246K_G7mHU
齐俊元想做的,是「你开口之前就把事做完」
第三篇是赛博禅心走访 Today AI 办公室的对话记录。作者说得很清楚:不涉及实测,只是取经。
Today.ai 是齐俊元的新作品,定位下一代 Personal Agent。有个细节我特别喜欢:他在 2014 年就买下了 today.ai 这个域名,当时想做 AI 个人助理。十二年,一个域名等他等到现在。
团队给的答案很干脆:他们和其他产品的差别在两点——长程 Memory 和主动性 Proactive。
大部分 Agent 的使用是从一个具体任务开始的:我提需求,它调工具,交付结果。Today 想让助理长期围绕同一个人工作,对你的了解随着使用不断积累,影响后面的安排,也帮助它判断下一件值得做的事。
第一个问题:拿到日历和邮箱权限,一个 Agent 就了解你了吗?
这个问题是 Today 团队反问作者的。他们的拆解很细:收到一封邮件,很多时候意味着别人想让你做什么;而你主动发出去的邮件,更可能在介绍自己、表达需求、作出承诺,那是你的意图。这些都是明面信息。但如果是一个人类秘书,也会关心行为信息——比如某个来源的邮件你一直不读,这也是信息。但没读未必是不感兴趣,过去的兴趣也未必一直有效。
由此得出一个判断,我觉得是整篇最有分量的一句:
如果只是写一个很通用的提示词,让模型把它认为重要的事情记下来,通常效果很差。
即便拿到同一个邮箱,两个 Agent 形成的记忆和建议仍然可能很不一样。所以他们的结论是:记忆系统需要针对具体场景设计——收集哪些信息、怎样理解人的行为、什么值得记下来,都要把对场景的理解放进去。他们把这些整理在 Memories 里,记录个人背景和偏好,后续的交互与反馈会继续修正这份记忆。
作者追问了一个很尖锐的问题:这里有很多先验经验,人只负责给反馈,我们会不会越来越像一家数据标注公司?团队不认同,说这依然是产品经理的工作——你很懂一个领域,就把这种理解放进产品,让更多用户受益。作者换了个说法:先验经验之于 harness,如同数据之于模型。团队觉得这个说法更接近——模型可以一样,但对人的理解不一样,做出来的助理就会有差别。
第二个问题:北极星指标是什么?
答案是 DAU。用户主动发起 query 的次数,优先级被放得非常低。他们最关心的是:Agent 主动帮用户解决了哪些问题。
「我们做的是主动性的 Agent,希望用户在开口之前,Agent 就直接把事情做了。」
产品示例里有个场景我很喜欢:你昨晚睡了不到六小时,上午十点又有品牌评审,它会问,要不要把今天的长距离散步挪到晚上,先准备评审文档。这里用到的既有原来的计划,也有新发生的情况。它还会提前整理当天的简报,让用户打开产品时就能看到今天要处理的事。
第三个部分,是我觉得这篇最实用的地方:用 Today 替代自己的外教。
Today 的 PM Suki 分享了自己学外语的过程:先做一轮测试,测完建很多 scheduled tasks,告诉它周一学什么、周二周三学什么;它根据反馈调整课程计划——你说最近不想学这些单词,想难度更高一点,或者换一个 topic,第二天计划就调整。它个性化的地方是「这个课程完全 for 我一个人」。她还会把生活里的熟人编进课程当角色,后来发现自己更喜欢互动学习,又让它做了一个拼词游戏。她的总结是:「整个过程完全替代了我的外教老师。」
作者由此提炼出一条找需求的思路,我觉得这条比很多方法论都值钱:
看人们原来在为什么花钱。1v1 外教和健身教练都是先了解你的水平、再安排课程、跟进学习、再根据反馈调整,恰好是 Agent 现在就能干的。
然后是最难的一块:开放世界的判断。
工作 Agent 好评估,代码写得能不能跑一眼就知道。但个人 Agent 面对的是开放世界,充满主观判断。作者举的例子特别狠:「帮我给邻居发邮件,让他别再吵了。」假定邮件发出去了,这个 task 算成功了吗?未必。我的真实需求不是「发出邮件」,而是「让他别吵」。
联合创始人高策的答案仍然落回 Memory 和 Proactive:用户长期以来是什么样的人、最近发生了什么、什么事值得主动去做,都需要产品持续组织和使用相关信息,不能只靠模型当下的 working memory。
作者最后自己加了一句判断,挺敢说的:这赛道纯应用层能不能跑通?他觉得创业团队要活下来,避免跟巨头正面竞争,还是得走硬件路线,推出自己的 Context 收集产品。
我的看法。
第一,这篇最扎实的地方是它承认了「记忆」不是技术问题,是产品问题。所有人都在说「给 Agent 加记忆」,但真正难的是决定记什么。发件箱比收件箱更值得记,因为发出去的才是意图;某个来源的邮件你一直不读,也是信息,但「不读」的原因可能有一百种。这种颗粒度的判断,是产品经理的活儿,不是模型能力的活儿。这也是为什么团队会说「先验经验之于 harness,如同数据之于模型」——他们都同意,这个比喻才立得住。
第二,北极星选 DAU 而不是提问次数,这个决定值得琢磨。提问次数是一个「用户来伺候产品」的指标,DAU 是一个「产品伺候用户」的指标。选前者,团队会去优化唤醒、推送、入口;选后者,团队只能去优化「它到底替我解决了什么」。这两个方向会长出完全不同的公司。
第三,「看人们原来在为什么花钱」这条方法论,我觉得比文章本身更有生命力。它绕开了「AI 能干什么」这个从技术出发的问题,直接问「哪些钱正在为一种可以被拆解的流程付费」。1v1 外教贵,贵在三件事:了解你、给你排计划、每周等你。前两件 Agent 已经能干,第三件最难——因为「有个真人每周等你」本身就是产品的一部分,是压力,也是关系。Agent 能替掉流程,但很难替掉「有人在等你」这件事。 这也是我对「完全替代外教」这个说法保留一点的原因:语言学习里,那点社交压力可能才是续费率的关键。
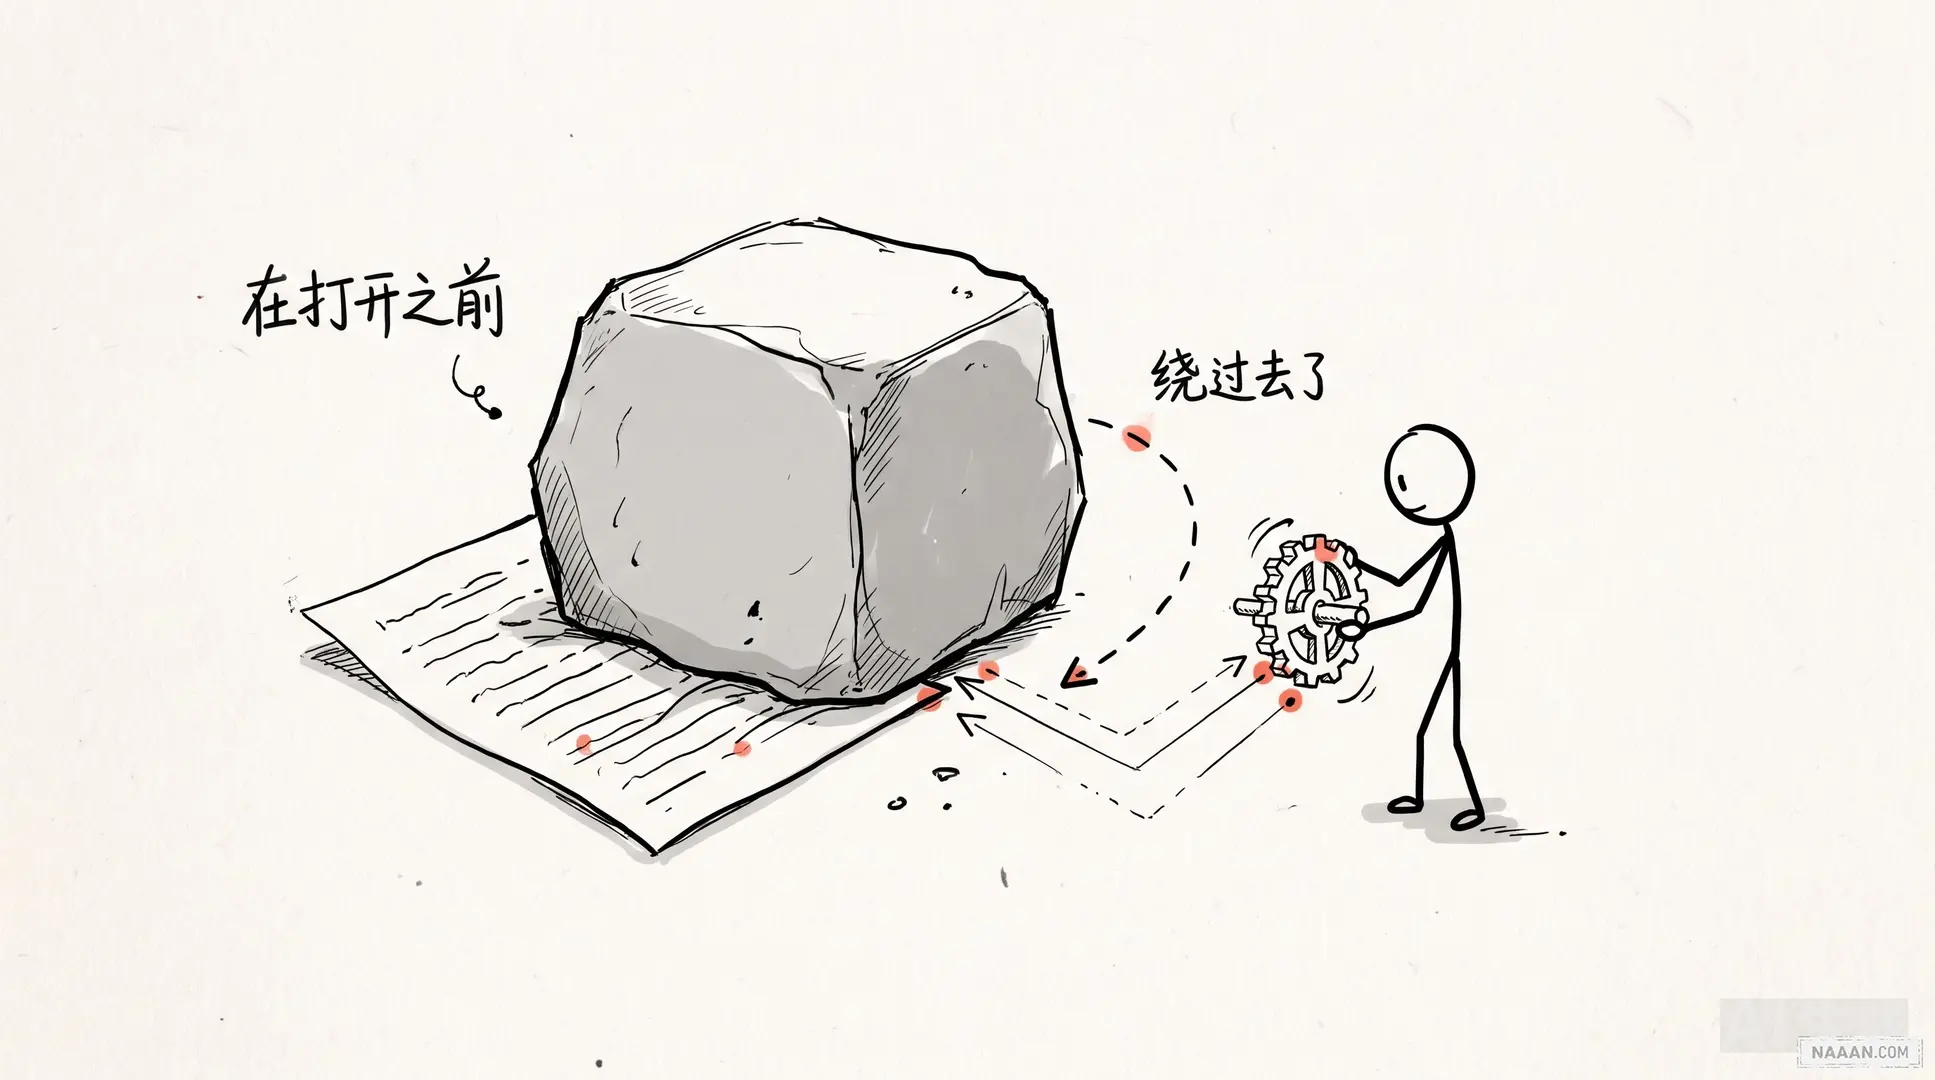
第四,我翻到了文章附录里齐俊元 2014 年写的那段话,看完有点感慨。他写:「我的代办事项清单已经堆了满满几百项,连点开的勇气都没有。待阅软件更是连数字都已经没法显示,直接是一个无穷大的符号。原因却很简单,这是事没有在我应当处理的时候去做,后来就不断拖延,日复一日,终于成为再也无法撬动的巨大石阵。」
十二年过去,问题一个都没变。变的只是我们终于有了一个可能撬动石阵的东西——而它撬动的方式,不是把清单整理得更漂亮,是在你打开清单之前就动手。
原文:赛博禅心《对话 Today AI》
🔗:mp.weixin.qq.com/s/KGkqa0y-DLGMNC9Zu1C9SA
下一代人不会知道自己的 Agent 用了什么软件
LukeW 这篇是这周读到的、把「抽象层次」讲得最清楚的一篇。他先回顾了自己去年画的那张 AI 产品演进图,当时的结论是「下一步必然是模型之间互相协作去完成任务」,现在确实到了 Agent 编排阶段。那再下一步呢?
他的观察起点很具体:最前沿的那批开发者,已经在同时盯着上百个、有些情况下更多的 Agent 协作写代码、测试、发布。 聊天时代诞生的开发工具根本扛不住这个量。
于是他们把自家的开发工具 Intent 重做并开源了。做法是把任务拆成一个个隔离的 workspace,每个 workspace 有独立的文件副本,Agent 之间不会互相踩;每个 workspace 跑在「活的 spec」上,配一个 coordinator 负责拆活、派给专门的子 Agent、不需要人一直盯着;上面还有更高一层的 Agent,跨多个 workspace、多台设备统管。
重点词是两个:observability(看到在发生什么)和 introspection(搞清为什么)。
然后是那句真正让我停下来想了一会儿的话:
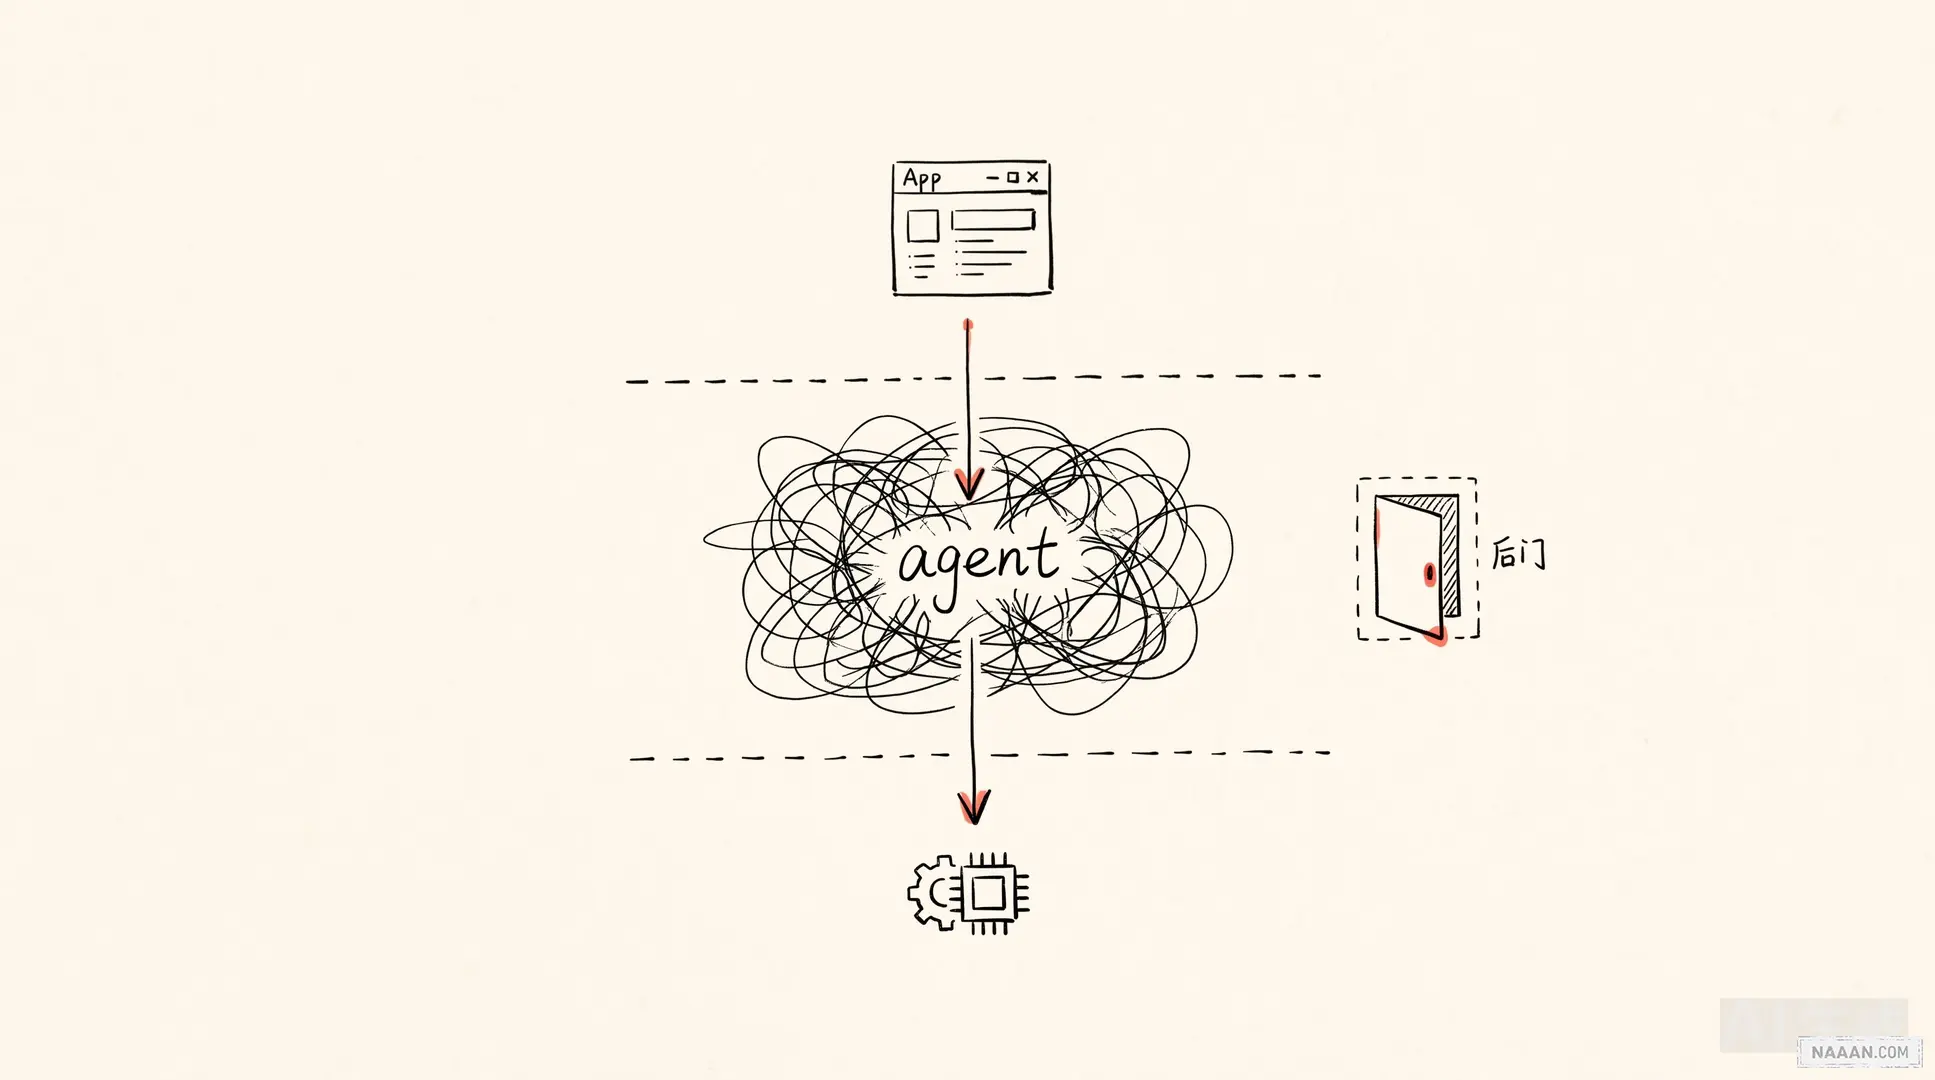
就像大多数电脑用户不知道也不关心自己的应用跑在什么代码上,更不用说操作系统为了和硬件打交道而跑的更深的代码——他们很快也不会知道、不会关心自己的 Agent 是怎么使用电脑上的应用的。一层新的抽象会让人们以另一种方式完成工作,那种方式不需要他们了解(更不用说学会使用)我们今天花所有时间打交道的软件。
我的看法。
第一,这篇的价值在于它给出了一个时间尺度。大多数人讨论「AI 会不会取代软件」时,想的是「软件消失」。LukeW 说的不是这个——软件还在,只是退到了你看不见的那一层。他拿操作系统打比方,这个类比很准:你今天用电脑,不知道文件系统怎么调度 inode,也不影响你用电脑。下一代人用 Agent,不知道它调了哪个 App 的哪个接口,也不影响他把事办成。软件没有消失,它变成了 Agent 的手。
第二,也是我觉得需要补一句的地方:抽象层次每上一级,效率提升,同时人对底下的知情权减少一级。这是同一枚硬币。你今天不知道 inode 怎么调度,代价是文件系统出问题时你束手无策;下一代人不知道 Agent 怎么用软件,代价是当它用错的时候,你连「它错在哪一步」都说不出来。所以他才把 observability 和 introspection 放在那么重的位置——那不是产品功能,那是给抽象层留的一扇后门。
这也正好接上 141 期聊的「接缝」:上一期说软件之间那些缝需要有人填,这一期说缝会被抽象掉。但抽象掉不等于消失,它只是从你眼前移到了你看不见的地方。缝还在,只是你不知道它什么时候裂。
原文:Luke Wroblewski《AI Agents and Layers of Abstraction》
🔗:lukew.com/ff/2159/ai-agents-and-layers-of-abstraction
🌊 本周产业:三家在同一周做同一件事,但在三个不同的层
翻这一周的产业新闻,有个巧合让我觉得不是巧合:10 月 12 日 Meta 发新模型,10 月 13 日 Gemini 4 Argon 全球开放、千问的 AI 眼镜和耳机同日开售。三天之内,模型层、Agent 层、硬件层各来了一记。
模型层:上下文变成一整座图书馆。
Gemini 4 Argon 在 10 月 13 日面向全球开放,当天 API 就直接全量可调。最硬的一个数字是单次输出上限从上一代的 6.4 万 token 拉到 100 万,上下文窗口 1,048,576,编码基准 DeepSWE v1.1 拿到 77.9%,定位在软件工程、企业知识工作、网络安全防御这类复杂长流程任务。API 给了限时五折——输入每百万 token 2 美元、输出 10 美元,优惠到 11 月 30 日,之后恢复 4 美元和 20 美元。
Meta 这边,10 月 12 日发布 Muse Wonder 和 Muse Wonder Full,内部代号「西瓜」,是超级智能实验室成立以来的首个前沿模型系列。最值得注意的不是跑分,是路线拐弯:Meta 首次放弃开放权重,转向闭源。Muse Wonder 走 API(每百万 token 输入 4 美元、输出 20 美元),更强的 Wonder Full 不开放 API,只放进 Muse Code 每月 50 美元和 200 美元的订阅档。
它主打的两个能力,恰好和 Today AI 是同一个方向:Active Memory(主动记忆),跨会话保留用户相关信息,不用每次都重新自我介绍;Active Focus(主动专注),遇到障碍时换条路而不是直接停住,必要时回来跟用户确认。
Agent 层:从「记得你」到「不中途卡死」。
你注意到没有,Meta 和 Today 说的是同一件事的两种说法。一个从模型能力出发,一个从产品指标出发,但落点都是:Agent 的价值不在单次回答,在长时段里那个「不用重新交代」的连续性。
这也是为什么 Today 把北极星定在「主动解决了多少问题」而不是「被问了多少次」。单次回答的边际价值正在被踏平——那正是「器」的部分。剩下的是连续性,是「它知道你上周说过什么」,是「它在你没说的时候已经在做了」。连续性不是能力,是关系。关系不好被商品化。
硬件层:Agent 从口袋里被拿出来戴上。
10 月 13 日,千问正式开售 AI 眼镜 N1 / N1 Pro 和一款 AI 耳夹式耳机。眼镜到手价 2218 元起,耳机 1099 元起。N1 系列是 5000 万像素影像,支持全天候环境感知、翻译、会议纪要、语音办事;N1 Pro 多了三样——体征实时监测(心率、血氧、皮肤温度)、眼动交互、虹膜核身(和蚂蚁 gPass 共研,误识率低于百万分之一,配合支付宝「看一下支付」)。耳机是千问和 Bose 一起做的开放式耳夹,支持 89 种语言实时翻译和会议听记,也能语音交办后台任务。
千问事业部副总裁宋刚的说法很直接:AI 穿戴是千问在物理世界的延伸,也是 Personal Agent 的重要组成部分;App 让 Agent 拥有办事能力,硬件则让它更好地进入真实世界、具备主动服务能力。
把三件事叠在一起看,我觉得有个判断可以下:
它们都在抢同一个位置——用户开口之前的那个位置。
模型层靠「把整个库一次喂进去」抢,Agent 层靠「记住你、别卡死」抢,硬件层靠「一直在你身上、能主动感知」抢。三条路完全不同,但终点一致:谁能在你要开口的时候已经在做了,谁就拿走了这个入口。
而「利不在器」正好解释了为什么这件事这么急:模型和硬件都是器,都在以肉眼可见的速度商品化——今天 100 万上下文是旗舰配置,明年就是标配;今天 2218 元的眼镜是新品,明年就是大路货。器会被踏平,所以必须抢器之外的东西。 那个东西叫「它已经在替你做事了」,也可以叫「你懒得换掉它了」。
这里还有一层我觉得更值得警惕:硬件是用物理存在换上下文。一副一直戴着的眼镜,知道你在哪、看着什么、心率多少、和谁说话。这份上下文的浓度,是手机永远给不了的。而「主动服务」这四个字要成立,前提就是这种浓度。所以这一轮的竞争,表面上是抢入口,实质上是抢「谁被允许知道你最多」。
这条线,我猜明年会有很多麻烦。
🛠️ 工具与技能
给 Agent 装上手和眼:三件绕开 API 的东西
这周工具区最让我感兴趣的不是某个「更好用的 AI 应用」,而是三件同类的东西——它们都在做一件事:让 Agent 直接操作那些没有 API 的东西。
第一件,iPhone Use。 一句话说清:让 Codex、WorkBuddy 或豆包工作通过 USB 操作你的真实 iPhone。自然语言描述任务,助手就能打开 App、读取页面、点击、滚动、输入文字、整理列表,并在侧边栏实时展示手机屏幕。底层用 WebDriverAgent(WDA)和手机通信,自带本地 MCP 服务、安装技能和实时屏幕 widget。控件定位失败时,它会退回去看截图、试着按坐标点击。
我要特别说两个细节,因为它们决定了这东西能不能真的用起来。第一,它需要你先在自己的 iPhone 上安装、签名并启动 WDA Runner——也就是说,你得有 Apple 开发者账号、完整 Xcode,以及一点耐心。仓库目前还是私有的,需要有访问权限或已取得的源码包。第二,它默认会发匿名使用统计(PostHog + GA4),包括工具调用、耗时、错误类别、启动过的 App 标识,但不上传手机画面、输入内容、设备标识,可以用环境变量关掉。
我欣赏这种坦白。太多「让 AI 操作手机」的项目,第一屏只放一段炫酷演示,把「你得先自己去签个名」藏到第五节。
第二件,ESP32 iPhone Agent。 这个更邪门,也更便宜:一块约 7 美元的 ESP32-S3 板子(实测用 Seeed Studio XIAO ESP32S3,8MB PSRAM),加一台 iPhone,就能让 AI 自己操作手机——订闹钟、改设置、点来点去全自动。
它的架构我读了两遍才完全想明白:手机把屏幕镜像(AirPlay)投到板子上,板子只做 H.264 透传、不解码,通过 BLE 转发给手机里的 App;App 解码、截图发给任意 OpenAI 兼容的视觉模型,跑一个 planner 和一个 actor;动作则通过板子的 USB HID 冒充鼠标键盘,配合 AssistiveTouch,鼠标点击就是触摸,拖动就是滑动。
也就是说,板子是「眼睛 + 手」,App 是「脑子」,全在手机上跑,不用电脑、不用越狱、不用开发者账号。作者说最新版连电脑都砍掉了。要求是 iOS 18 以上,手机得用蜂窝数据(Wi-Fi 被板子占了热点),Lightning 机型还得配个转接头。
我特别喜欢里面一个工程细节:因为指针是相对坐标,App 会自己跟踪它、把它「归位」到角落;在精确点击之前,它会让指针先抖一下、在屏幕上找到它、把误差纠正回来。这个动作很像人——你摸黑找鼠标时也会先晃一晃。
这个「抖一下」比任何 demo 都更让我相信这东西是真的。
第三件,REA(Reverse Engineer Anything)。 前两个是装手,这个是装眼睛,但看的是另一层:让 AI 编程助手把一个软件拆开看内部。装法一行命令(npx rea-agents@latest setup),然后你就用大白话问——官网首页那个例子我印象很深:「为什么 Windows 计算器 200 + 10% 算出来是 220?」Agent 会去读 x64 汇编,顺着分支和调用链,把那套规则还原出来,再翻译成人话。
官网的说明写得很克制:逆向工程就是通过检查程序本身来了解软件怎么工作。有了 REA,你的 Agent 可以跟着代码走、解释一个功能、帮你把它重建出来。
三件放一起,我想说的是这件事:
过去十年,我们对「软件」的理解建立在一个假设上——软件是可被调用的。你有 API,我就集成;你有界面,我就学。所以「会用」是一种能力,因为界面是给会用它的人留的。
这三件东西都在拆这个假设。ESP32 那块板子不知道什么 API,它只知道「屏幕上有个东西,我点一下看看变不变」;REA 不看文档,它看机器码;iPhone Use 不看你的 App 有没有开放接口,它读控件树、忘了就截图。
也就是说,当 Agent 的手绕过 API、直接伸到像素和寄存器上,「会用某个软件」这件事就彻底不再是壁垒了。 它不需要会,它只需要看得见、点得到、试得出来。
这件事的另一面是社会性的。当「绕过界面」变成一种常态能力,平台一定会开始防——防自动化、防爬取、防风控。事实上这一周的新闻里就有:字节想让豆包手机助手直接操作不同 App,而微信、支付宝、淘宝、美团等一百五十多款应用明确拒绝了屏幕自动化操作。
这不是技术问题,是收租权的问题。API 是器的接口,谁掌握接口谁收租;Agent 直接看屏幕,就把「器」降级成一个不需要授权的显示面。所以未来两年,你会看到一场很奇怪的拉锯:一边是越来越强的「看得见就能操作」,一边是越来越严的「你怎么证明你是人」。
我不知道谁赢。但我知道,站在 API 那一侧的生意,护城河是租约;站在像素那一侧的生意,护城河是耐心。
- iPhone Use:🔗 github.com/zhongerxin/iPhone-use
- ESP32 iPhone Agent:🔗 github.com/onehumanbeing/esp32-iphone-agent
- REA:🔗 rea.tools
- Intent(LukeW 团队的 Agent 协调工具):🔗 intentapp.dev
三件小而硬的东西
Mole 出了 Windows 版。 这是《潮流周刊》作者自己做的清理工具。Mac 版做了很久,这次 Windows 版拢共开发了差不多两个月——中间他测试了 349 款软件的卸载、清理、更新、启动和注册表,专门整理了一台 ThinkPad 来开发。早鸟价 15.2 美元,买过 Mac 版的老用户用 MOLEAGAIN 可以 10 美元拿下。
我留意到的是「349 款」这个数字。清理类工具的说服力不在界面好看,在它敢不敢碰那些冷门软件的残留。这个数字本身就是产品说明书。
Paper Mono,一款免费开源的等宽字体。 设计工具公司 Paper 自己做的,800 个字形、8 档字重、支持可变轴和 100 多种语言,框线字符、编程连字、斜杠零都配齐了。
会做字体的人都知道,等宽字体最难的不是「对齐」,是在不同字重下保持节奏一致。8 档字重加可变轴,意味着它既能当代码字体,也能拿排正文和标题——这种「一种字吃三个场景」的设计,通常是内部工具做久了才会有的实用主义。
526 种中国传统色的 Figma 文件。 这个严格说不算工具,是一个资源包。里面不少颜色确实好看,做产品找不到配色的时候可以去翻。我把它的价值理解成**「减少默认审美」**——大部分人做的界面之所以看起来都差不多,不是因为懒,是因为默认色板就那几个。有一个 526 色的池子摆在那儿,至少让「随手选一个」的结果不那么像随手选的。
🔗:figma.com/design/5gJsBEyypBoGo48GFRcd4F
✨ 随便看看
11 个人,撑起 14 座城市的数百张酒桌。 AI 社交产品 Table for Six(T46)2025 年末开始运营,已拿到 BAI Capital 和某游戏公司累计数百万美元天使轮,累计付费用户超过 4 万。用户付 88 或 118 元,得到一杯饮品和一场由 AI 匹配的陌生人聚会。AI 在后台干的活,恰好是传统「主理人」的核心工作:从问卷里提炼匹配准则,平衡年龄、性别、内外向和社交能量,为每桌生成专属卡牌,甚至用六个 Agent 模拟参与者预演对话气氛;运营端由 5 个主 Agent 及其子 Agent 跑完排桌、选场地、生成打印文件、对接印厂、核对装盒、下闪送订单。11 个都在上海的员工,就这样撑起了 14 城数百桌。最戳我的是记者那句反问:整个过程里,我几乎没有直接与 AI 交互。AI 把自己藏进了流程,只把人留给人。 这可能是「利不在器」最好的一个注脚——用户根本不知道,也不需要知道你用了多少 Agent。
🔗:mp.weixin.qq.com/s?__biz=MzI2NDk5NzA0Mw==&mid=2248906422&idx=1&sn=c4e30d859a02d3b3218fbbb7d43a9bb1教别人用 AI,从 19.9 元卖到 30 万。 五位从业者的自述:北京一位创始人 3000 元一门课教 AI 视频,学员不到二十人,她没打算做成长久生意,因为「AI 变化越来越快」;一位 AI 应用顾问用 AI 生成课程内容,已排到 33 门大课、400 多节,个人课月费 19800 元,企业培训单堂可达 30 万元;南京一位法律顾问专教律师用 AI,线下小课一堂三五万,收入已超过做律师时。这篇最诚实的一句是那位法律顾问说的:「这种信息差能维持多久,我并没有把握。」AI 一边消灭信息差,一边制造新信息差,而这门生意的窗口期可能只有一两年。卖「器」的,最终会被自己卖的器吃掉。
🔗:mp.weixin.qq.com/s?__biz=MjM5ODMzMDMyMw==&mid=2654912867&idx=2&sn=ca0eafe6bc4de656ed8518a237007cdd30 多人的公司,花 5 天把自己改造成 AI 原生。 数字生命卡兹克的这场改造里,最值得抄的不是他用了什么模型,是最后一个动作:他把整套中台包成了一个 MCP。员工只要把一段 Prompt 发给自己的 Agent,就能自动安装 MCP、发布应用、分配子域名和权限。他复用了飞书的权限体系和数据同步,还支持千人千面的首页——每个员工的首页由 Agent 根据账号 ID 自动生成。他期待的场景很具体:新员工入职第一天发现流程蠢,同事自然地说「那你让 Agent 改一下呗」,第二天新应用就上线,全公司都用上。这句话如果真能发生,那才是「组织」这个词被重写的时刻——过去是员工适应公司系统,接下来是公司系统适应每一个活生生的人。
🔗:mp.weixin.qq.com/s?__biz=MzIyMzA5NjEyMA==&mid=2647686948&idx=1&sn=d43b6d924d339092f96e3ba826119f6c一份账单:一个月烧掉两个 250 美元的 Claude 账号。 《潮流周刊》作者算了一笔账,我看了很久。他的配置是 2 个 Claude Max 250 美元 + 1 个 ChatGPT Pro,日常用 opus 5.5 medium 档跑普通任务、high 档跑复杂任务,Codex 默认 GPT-6-Astra medium。他说自己从 1 个 20 美元试起,到 2 个 20 美元,到 1 个 125 美元,再到 250 美元,直到现在的两个 250——「当时 AI 没出来前,包一个爱奇艺电视会员几十块一个月都会觉得贵的人,怎么现在对 AI 这么能花钱」。钱花在哪了?一台 Mac 上连着虚拟机、一台 ThinkPad X1、一个 Android 平板,24 小时开机远程连着,让 Agent 帮他在多环境里做测试验证;Kaku 里同时开 7 到 10 个 Tab 的 Agent 跑任务;每周用最好的模型把自己的对话、踩坑和最佳实践跑一遍,沉淀成开源的 Skills 合集。「这样就好比 Mac 是我的研发主力端,但它上面连接了一个虚拟机、一台 Windows 设备、一台 Android 平台。」我读这段时的感觉是,这就是「器」的另一种形态:当器不再需要你会用,你会开始囤更多器。
🔗:weekly.tw93.fun/posts/286一张图表应该隐含一个「下一步」。 体验碎周报这期转了一篇关于数据可视化的长文,里面有两个例子我很喜欢。一个是 1973 年 Anscombe 提出的四重奏:四组数据的均值、方差、相关系数、回归线全都一样,画成散点图却完全是四个故事——有的接近线性,有的明显弯曲,有的其实是几个离群点硬拉出来的。另一个是对 Tufte「数据-墨水比」的反驳:图表几乎从不在真空里被阅读,它总是被一个具体的人、在具体情境里、带着具体压力去看,把它一味压到最干净,有时恰好拿掉了决策者最需要的那层上下文。作者的原话是「简洁本身不是目标,合适的复杂度才是」。而整篇最狠的一句结论是:每一种可视化,都隐含着一个下一步——哪怕那个结论只是「现在暂时不需要改动」。
🔗:mp.weixin.qq.com/s/80Rl3-kn1t54RVmJW6NSdg一条值得抄进笔记本的管理观察。 胡渊鸣在 Meshy 的 ARR 突破 1 亿美元后写了 48 条反思,其中一条讲「惩罚责任心」:某位同事任劳任怨,leader 就把各种 dirty work 都交给他,他出于责任心做得很好,于是 leader 给了他更多 dirty work。从结果上看,他的责任心和任劳任怨,换来了更多 dirty work。如果没有其他方面的补偿,这一定是不公正、不可持续的。同类的还有:我们对父母的感激反而不如偶尔给小恩小惠的人;给老老实实做事的员工待遇不如会闹的员工;奖励加班的同事而不是更高效做出成果的同事。他的解法是「扪心自问」——如果有一天所有人的薪资因为某种意外被公开了,大家会觉得这样的安排公平吗?这篇是 5 个板块 48 条,从 8000 万美元 ARR 写到 1 亿,国庆期间花了五天删掉三分之二。值得整篇读。
🔗:mp.weixin.qq.com/s?__biz=MzkyNTE1MjYzNg==&mid=2247484262&idx=1&sn=14628187e5f8beaf1a26456ecd2636ef
写到这里,我回到开头那个问题。
那位朋友后来又问了我一句:「那我是不是不用学了?」
我说不是,但你学的东西得换。你现在花力气去记「这个功能在哪一栏」,两年后就白记了;你花力气去搞清「这件事到底该怎么判断才对」,两年后只会更值钱。
因为「会用器」这件事,正在被批量地、彻底地踏平。这不是坏事——它意味着那道人人都得排的队取消了。但它也意味着,你不能再靠「我会用一个别人不会用的东西」来证明自己的价值了。
这不是一个舒服的消息。
过去我们靠器给自己定位:我是做设计的、我是写代码的、我是搞数据的。这些身份背后都藏着一个「我熟练掌握了某个东西」。当那个东西开始贬值,身份就跟着晃。这一周我读到的每一份材料,其实都在从不同角度描述同一次晃动:周喆吾说单点能力必然趋零,YC 说组织知识该搬进数据库,齐俊元说别数用户问了几次、要数它主动解决了多少,LukeW 说下一代人根本不知道 Agent 用了什么软件。
而晃动之后,剩下的东西其实很清楚,只有两样:
一样是「知道要成什么事」——判断。在所有人都有同样的器之后,你和别人的区别只剩「你决定让它去做什么」。这个能力没法外包,因为它讨论的不是执行,是取舍:什么值得做,什么不值得,什么现在做,什么永远别做。
另一样是「出了事你认」——兜底。器越强,出错时的破坏力越大;抽象层越高,出错时你越看不清原因。所以那个愿意在没人看得见的地方签字的人,反而变得更贵。这不是道德上的贵,是结构上的贵:系统越自动化,人对剩余风险的承担就越稀缺。
有意思的是,这两样本期几乎所有材料都提到了,但没有一份把它们当成结论。它们被埋在 workflow capture、北极星指标、抽象层次底下,像一句没人愿意直说的话:器可以被踏平,但「成事」这件事,始终需要一个愿意为结果负责的人。
所以我这一期真正想说的,其实不是「AI 又强了」。恰恰相反——AI 强到一定程度之后,「强」这件事本身就不值钱了。
值钱的是那句老话。利不在器,在器所成之事。
只是这一次,我们终于有机会亲自验证它。
下期见。